Stand: 19. November 2026. Dieser Beitrag wird aktualisiert, sobald Microsoft den abschließenden Post-Incident-Bericht veröffentlicht.
Update vom 19. November 2026: Microsoft hat am 16. November einen vorläufigen Post-Incident-Bericht veröffentlicht, Charles Lamanna hat ihn auf X zusammengefasst. Ursache war demnach ein seit Juli unentdeckter Fehler in den Netzwerk-Gateway-Servern, über die Verbindungen zu Exchange Online aufgebaut werden. Unter bestimmten Lastbedingungen reagierten diese Server nicht mehr. Zum Ausfall kam es, als zusätzlicher Teams-Verkehr auf die Gateways traf, während wegen Wartungsarbeiten rund 14 Prozent ihrer Kapazität fehlten. Die Einzelheiten stehen unter „Zur Ursache“.
Die Abschlussmeldungen zu beiden Vorfällen hat Microsoft schon am Samstag, 14. November, gegen 5:15 Uhr MEZ veröffentlicht. Die längere Beobachtung des E-Mail-Rückstaus, von der im Update vom 14. November die Rede ist, hatte Microsoft am Vorabend angekündigt. Als Störungszeitraum nennt die Abschlussmeldung den 12. November, 17:20 Uhr MEZ, bis 13. November, 17:10 Uhr MEZ. Den abschließenden Bericht mit weiteren Gegenmaßnahmen hat Microsoft innerhalb von fünf Werktagen angekündigt, er wird um den 20. November erwartet.
Update vom 14. November 2026: Die Statusseite von Microsoft meldet am Samstagmorgen alle Produkte als betriebsbereit, sowohl für Geschäfts- als auch für Privatkunden. Formal abgeschlossen ist der Vorfall damit noch nicht. Microsoft beobachtet die Lage wegen der Schwere des Ausfalls über einen längeren Zeitraum weiter und wartet ab, bis der während der Störung aufgelaufene E-Mail-Rückstau vollständig abgearbeitet ist.
Microsoft hat sich für den Ausfall entschuldigt und erstmals eine Ursache benannt: Das Problem wurde demnach bei einem früheren Ausbau der Netzwerkkapazität eingebracht und trat nach einer kürzlichen Netzwerkänderung zutage. Charles Lamanna, Executive Vice President für Copilot, Agents und Platform, hat einen ausführlichen Bericht mit Zeitverlauf und Gegenmaßnahmen angekündigt. Ein Angriff war es nicht. Microsoft erklärt ausdrücklich, der Vorfall habe weder mit Cyberangriffen noch mit KI-Agenten zu tun.
Update vom 13. November 2026: Die Erholung kam in Wellen. Am Freitagvormittag meldete Microsoft erste Stabilisierung, am Nachmittag waren die E-Mail-Warteschlangen deutlich abgebaut und näherten sich dem Normalwert. Die Privatkundendienste waren am Freitag vollständig wiederhergestellt, bei den Geschäftskundendiensten sprach Microsoft von anhaltender Erholung. Insgesamt dauerte die Beeinträchtigung rund 24 Stunden.
Was passiert ist
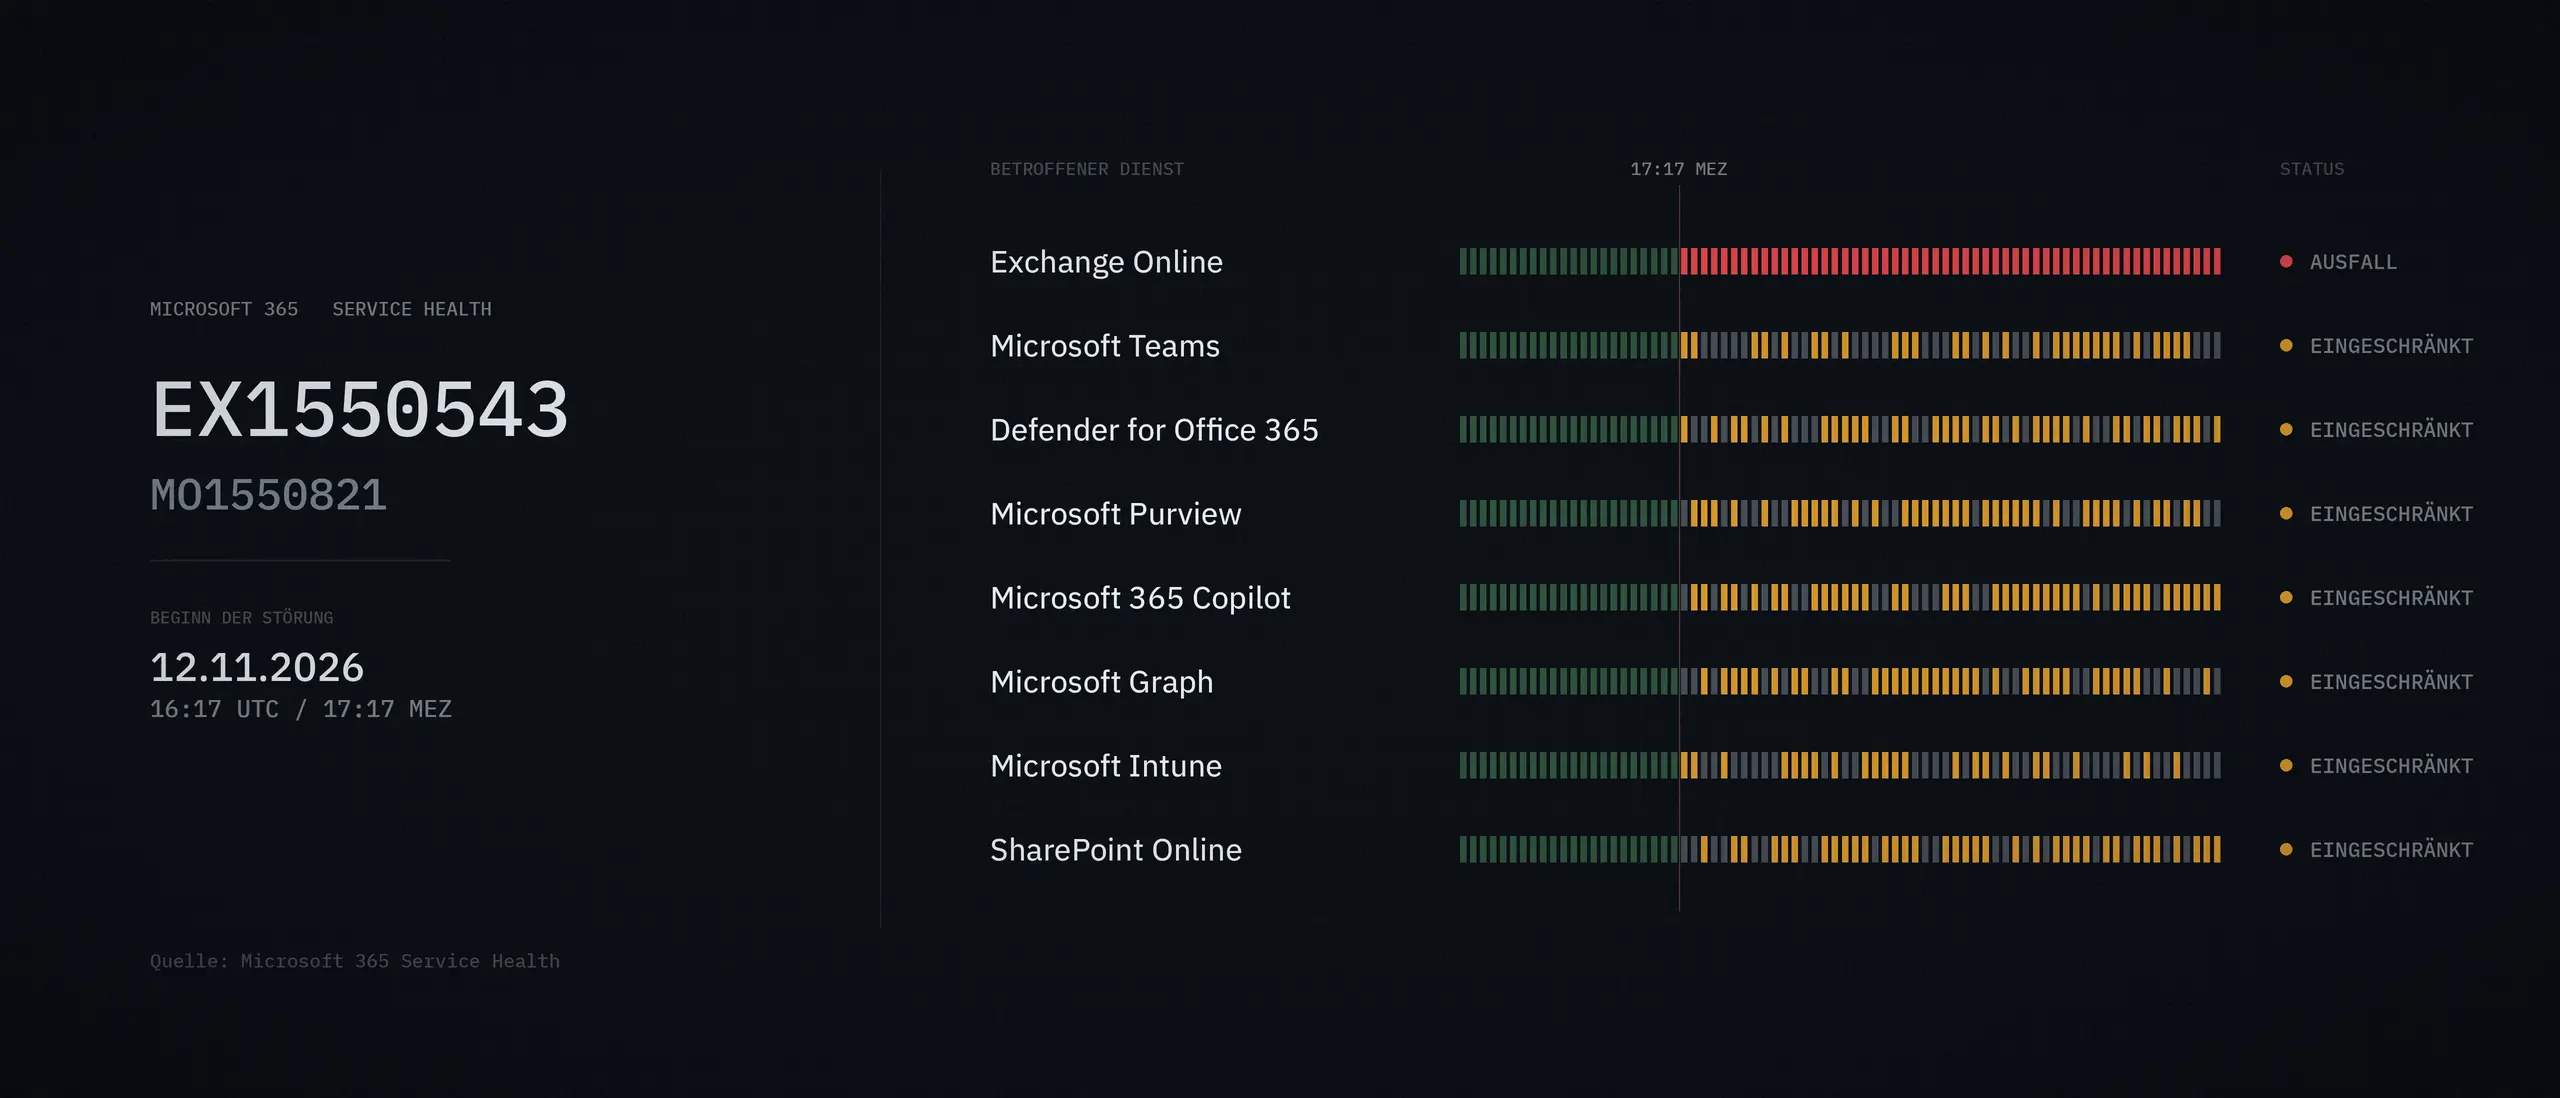
Am Nachmittag des 12. November 2026 begann eine weltweite Störung bei Microsoft 365. Anwender kamen über Outlook im Browser, Outlook am Desktop, Exchange ActiveSync und REST-Verbindungen nicht an ihre Postfächer, E-Mails wurden verzögert zugestellt. Weil zahlreiche andere Dienste auf Exchange Online zugreifen, reichten die Auswirkungen bis zu Teams-Kalendern, Defender for Office 365, Purview und Intune. Die Ursache lag vollständig in Microsofts Infrastruktur.
Microsoft führte den Vorfall unter der Kennung EX1550543 für Exchange Online und MO1550821 für die übrigen betroffenen Dienste. Als Beginn nennt Microsoft den 12. November 2026 um 16:17 Uhr UTC, das entspricht 17:17 Uhr MEZ. Auf dem Höhepunkt lagen laut Reuters allein aus den USA mehr als 130.000 Störungsmeldungen zu Outlook vor.
Reuters zählt den Vorfall als zweiten größeren Ausfall der 365-Dienste in diesem Jahr nach einer Störung im Januar.
Welche Dienste betroffen waren
Microsoft listete in der Sammelmeldung mehr als 15 weitere Dienste zusätzlich zu Exchange Online. Die Faustregel lautete: Betroffen war alles, was auf Exchange Online und E-Mail zugreift. Was ohne Exchange auskommt, lief weiter.
Exchange Online. Kein Postfachzugriff über Outlook im Web, Outlook am Desktop (MAPI), Exchange ActiveSync und REST. Die Zustellung eingehender E-Mails verzögerte sich. In Hybrid-Umgebungen stockte der Mailfluss zwischen lokalem Exchange Server und Exchange Online.
Microsoft Teams. Kalender, Einladungen und Besprechungsänderungen schlugen fehl, neue Live-Events ebenso. Private und geteilte Kanäle ließen sich nicht anlegen oder löschen. Besprechungen, Anrufe und Chats funktionierten nach Angaben von Microsoft größtenteils.
Defender for Office 365. Safe Links und Safe Attachments, Quarantäne, Threat Explorer und die Nachrichtenablaufverfolgung waren gestört. Von Defender umgeschriebene Links ließen sich nicht öffnen.
Microsoft Defender XDR. Einzelne Seiten im Defender-Portal luden nicht.
Microsoft Purview. DLP, Vertraulichkeitsbezeichnungen, Communication Compliance, eDiscovery, Audit-Suche und geschützte Inhalte waren gestört.
Microsoft 365 Copilot. Copilot Chat lud teilweise nicht und griff nicht auf E-Mails, Kalender und Dateien zu.
Microsoft Graph. Abfragen auf Mail, Kalender und Kontakte liefen in Zeitüberschreitungen. Das traf angebundene Drittanwendungen und Automatisierungen.
Microsoft Intune und Windows 365. Registrierung, Check-ins und die Auswertung von Compliance-Richtlinien waren zeitweise gestört. Cloud-PCs mit Purview Customer Key waren nicht erreichbar.
SharePoint Online. Funktionen mit Exchange-Bezug waren gestört, Dateien in SharePoint blieben erreichbar.
Microsoft 365 Apps und Admin Center. In den Office-Apps fehlte teilweise die Liste der zuletzt verwendeten Dateien, Cloud Update, Cloud Policy und Inventar waren gestört. Einzelne Seiten im Admin Center luden nicht.
Microsoft Planner und To Do. Plan- und Aufgabenoperationen arbeiteten unzuverlässig, To Do lud teilweise nicht.
Power BI und Microsoft Fabric. Export und Bearbeitung von Inhalten mit Vertraulichkeitsbezeichnung schlugen fehl.
Universal Print und Microsoft 365 Education. Druckaufträge und Administrationsfunktionen waren gestört, in Education betraf es Aufgaben und Lesefortschritt.
Zur Ursache
Seit dem 16. November liegt Microsofts vorläufiger Post-Incident-Bericht vor, eine gekürzte Fassung hat Charles Lamanna auf X veröffentlicht. Demnach kamen drei Faktoren zusammen, alle in den Netzwerk-Gateway-Servern, über die Client-Verbindungen zu Exchange Online aufgebaut werden.
Ein Fehler aus dem Juli. Ein früherer Fix für die Gateway-Server enthielt einen bis dahin unentdeckten Fehler. Unter bestimmten Lastbedingungen reagierten die Server dadurch nicht mehr. Weil die Änderung schon im Juli 2026 ausgerollt worden war, konnten die automatischen Rückfallmechanismen sie nicht abfangen.
Mehr Last durch Teams. Rund 15 Stunden vor dem Ausfall wechselte Teams planmäßig von einem alternativen auf das primäre Gateway, das auch Exchange Online versorgt. Die Last auf diesen Servern stieg.
Weniger Kapazität durch Wartung. Wegen Wartungsarbeiten an den Gateway-Hosts fehlten zu diesem Zeitpunkt rund 14 Prozent der Kapazität.
Damit präzisiert Microsoft die erste Erklärung vom Freitag, nach der das Problem bei einem früheren Ausbau der Netzwerkkapazität eingebracht worden war und nach einer kürzlichen Netzwerkänderung zutage trat. Microsoft hatte gleich zu Beginn alle Deployments gestoppt und den Rückbau kürzlicher Konfigurationsänderungen geprüft. Gegen einen Fehler, der seit Monaten im System steckte, half das nicht.
Den Mechanismus hat Microsoft während des Vorfalls ungewöhnlich detailliert beschrieben. Im Mittelpunkt standen die Frontend-Server von Exchange Online, also die erste Station jeder Client-Verbindung. Die Überlast kam nicht von mehr Verkehr. Eine Reihe von Servern fiel unerwartet aus, die verbleibende Infrastruktur übernahm deren Last. Ein Kernprozess auf diesen Servern wurde daraufhin überlastet, die Server bestanden die automatischen Zustandsprüfungen nicht mehr und wurden aus dem Verkehr genommen. Deren Last verteilte sich wiederum auf die übrigen Server.
Das ist das Muster eines Kaskadenausfalls, und es erklärt, warum ein Neustart allein nicht half. Zurückgeholte Server fielen sofort wieder aus, sobald sie den aufgestauten Verkehr erhielten. Microsoft musste den Verkehr drosseln, umleiten und einzelne Verkehrsarten gezielt sperren, damit die Server überhaupt stabil anlaufen konnten. Behoben hat Microsoft den Fehler schließlich mit einem Hotfix: Die Server wurden gruppenweise vom Netz genommen, aktualisiert und neu gestartet.
Einen Angriff schließt Microsoft aus. Der Vorfall habe weder mit Cyberaktivitäten noch mit KI-Agenten zu tun. Den abschließenden Post-Incident-Bericht mit dem vollständigen Zeitverlauf und den geplanten Gegenmaßnahmen hat Microsoft innerhalb von fünf Werktagen nach Abschluss des Vorfalls angekündigt. Er erscheint im Admin Center unter EX1550543 und MO1550821.
Zeitlicher Verlauf
- 12.11., 17:17 Uhr MEZ: Beginn der Beeinträchtigung nach Angaben von Microsoft, Vorfall EX1550543
- 12.11., 18:54 Uhr MEZ: Erste öffentliche Meldung, zunächst für Nord- und Südamerika
- 12.11., 19:26 Uhr MEZ: Microsoft eröffnet MO1550821 für die übrigen Dienste und bestätigt, dass Anwender in allen Regionen betroffen sein können
- 12.11., 20:12 Uhr MEZ: Microsoft stoppt alle Deployments, verlagert Verkehr weg von der betroffenen Infrastruktur und startet betroffene Server neu
- 12.11., 20:31 Uhr MEZ: Microsoft stellt fest, dass die Last nicht von mehr Verkehr kommt, sondern vom Ausfall einer Reihe von Servern, und prüft den Rückbau kürzlicher Konfigurationsänderungen
- 12.11., 23:09 Uhr MEZ: Die Maßnahmen bringen nicht die erwartete Entlastung, ein überlasteter Kernprozess wird als Grund für den Kapazitätsverlust benannt
- 13.11., 01:06 Uhr MEZ: Rückschlag, zurückgeholte Server reagieren erneut nicht mehr, sobald sie Verkehr erhalten
- 13.11., 04:13 Uhr MEZ: Microsoft räumt ein, dass die angewandten Änderungen nicht wie erwartet greifen, und sucht andere Wege, Kapazität zu schaffen
- 13.11., 05:36 Uhr MEZ: Teilweise Erholung durch angepasste Protokolle, Umverteilung und gezielte Sperren, aber nicht dauerhaft
- 13.11., 10:24 Uhr MEZ: Erste Stabilisierung, Microsoft verlängert den E-Mail-Timeout auf 48 Stunden
- 13.11., 12:11 Uhr MEZ: Verbesserungen beim Postfachzugriff und bei der Verarbeitung verzögerter E-Mails
- 13.11., 14:32 Uhr MEZ: Breitere Erholung in Nordamerika, anhaltende Verbesserung in weiten Teilen Europas, erste positive Signale in Asien und im Pazifikraum
- 13.11., 15:17 Uhr MEZ: Die E-Mail-Warteschlangen sind deutlich abgebaut und nähern sich dem Normalwert
- 13.11., Nachmittag: Microsoft benennt den Ausbau der Netzwerkkapazität als Auslöser und entschuldigt sich
- 14.11., 05:15 Uhr MEZ: Abschlussmeldung zu EX1550543 und MO1550821, Störungszeitraum laut Microsoft 17:20 Uhr MEZ am 12.11. bis 17:10 Uhr MEZ am 13.11.
- 14.11., Vormittag: Die Statusseite meldet alle Produkte als betriebsbereit, Microsoft beobachtet den E-Mail-Rückstau weiter
- 16.11.: Microsoft veröffentlicht den vorläufigen Post-Incident-Bericht, Charles Lamanna fasst die Ursache auf X zusammen
Was jetzt zu prüfen ist
Nachlaufende und doppelte E-Mails. Microsoft hat den E-Mail-Timeout auf 48 Stunden verlängert, damit verzögerte Nachrichten nicht verworfen werden. Mails aus dem Störungszeitraum können deshalb noch mit erheblicher Verzögerung und in unsortierter Reihenfolge eintreffen. Wer während der Störung mehrfach manuell gesendet hat, dessen Nachrichten kommen möglicherweise mehrfach beim Empfänger an.
Hybrid-Umgebungen: Warteschlangen leeren lassen. Mails, die sich auf lokalen Exchange Servern in der Warteschlange zum Tenant gestaut haben, sollten jetzt abfließen. Wer den MessageExpirationTimeout während der Störung erhöht hat, setzt ihn nach dem Abbau wieder auf den Standardwert zurück.
Angebundene Anwendungen. Fachanwendungen, Ticketsysteme, Signatur- oder Archivlösungen und Automatisierungen greifen über EWS oder Microsoft Graph auf Exchange Online zu. Fehlläufe aus dem Störungszeitraum bleiben dort oft unbemerkt liegen, weil niemand aktiv davorsitzt. Ein Blick in die Protokolle dieser Systeme lohnt sich.
Nachrichtenablaufverfolgung. Im Exchange Admin Center lassen sich verzögerte, abgelehnte oder hängende E-Mails aus dem Störungszeitraum gezielt heraussuchen. Wer Nachrichten mit einem Non-Delivery-Report zurückbekommen hat, sollte diese erneut senden.
Aufgeschobene Vorgänge nachholen. Quarantäne-Freigaben, Einträge in der Tenant Allow/Block List und Purview-Auswertungen, die während der Störung nicht möglich waren, lassen sich jetzt abarbeiten. Compliance-Auswertungen aus dem Störungszeitraum sind unter Umständen unvollständig.
Intune und bedingter Zugriff. Den Compliance-Status der Geräte kontrollieren und Richtlinien, die während der Störung gelockert wurden, wieder scharf stellen.
Journaling und Archivierung. Lösungen von Drittanbietern auf Lücken im Störungszeitraum prüfen.
Sinnvoll ist außerdem eine kurze Grundkontrolle: eine interne und eine externe Testmail, ein Blick in ein freigegebenes Postfach und eine Kalenderänderung, die synchronisieren sollte.
Was während der Störung geraten wurde
Der Fehler lag vollständig serverseitig. Entsprechend galt und gilt für vergleichbare Fälle:
Abwarten statt eingreifen. Der Fehler wird auf Microsofts Servern behoben, nicht auf dem eigenen Rechner.
Outlook nicht neu einrichten. Kein neues Profil, keine Neuinstallation, kein Löschen und Neuanlegen des Kontos, und auch kein Zurücksetzen des Kennworts. Im Exchange-Cache-Modus bleiben bereits synchronisierte E-Mails, Termine und Kontakte lesbar. Ein neues Profil hätte keinen lokalen Cache und damit gar keine Daten. Microsoft hat während des Vorfalls ausdrücklich empfohlen, sich nicht von den Konten abzumelden.
E-Mails nicht mehrfach senden. Nachrichten im Postausgang werden nach der Entstörung zugestellt. Wiederholtes manuelles Senden führt zu Mehrfachzustellungen.
MX-Einträge nicht umstellen. Exchange Online Protection nimmt Mails weiter an, und Absender-Server stellen bei temporären Fehlern über Stunden bis Tage erneut zu. Eine kurzfristige MX-Änderung schafft mehr Zustellprobleme, als sie löst.
Safe Links nicht global abschalten. Umgeschriebene Links lassen sich während einer solchen Störung nicht öffnen. Die Schutzfunktion für alle zu deaktivieren, löst ein kurzfristiges Problem und schafft ein größeres.
Wo sich der Stand nachlesen lässt
Maßgeblich ist das Service-Health-Dashboard im Microsoft 365 Admin Center unter den Kennungen EX1550543 und MO1550821. Dort stehen auch der vorläufige Post-Incident-Bericht und später der abschließende. Das Dashboard ist tenant-spezifisch und setzt eine erfolgreiche Anmeldung voraus, die während dieser Störung selbst fehlschlagen konnte. Lädt das Admin Center nicht, zeigen die öffentliche Statusseite unter status.cloud.microsoft und der Statuskanal @MSFT365Status auf X dieselben Informationen in gekürzter Form.
Quellen und weiterführende Artikel
- Microsoft 365 Service Health, Vorfälle EX1550543 und MO1550821 mit vorläufigem Post-Incident-Bericht
- Microsoft 365 Status auf X (@MSFT365Status)
- Charles Lamanna, Zusammenfassung des vorläufigen Post-Incident-Berichts auf X, 16. November 2026: x.com
- Lawrence Abrams, Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide, BleepingComputer: bleepingcomputer.com
- Rafael Pfister, Liveticker: Exchange Online: weltweiter Ausfall der Postfachzugriffe: rafaelpfister.ch
- IT-Administrator, Microsoft 365: Störung legt zahlreiche Dienste lahm: it-administrator.de
- Nadine Dressler, Microsoft-365-Störung dauert an: Outlook, Teams und Co. betroffen, WinFuture: winfuture.de
- Jörn Walter, Microsoft-365-Störung EX1550543 / MO1550821, Der Windows Papst: der-windows-papst.de
- Aaron Greenbaum, We Now Know What Really Caused Microsoft’s Massive November Outage, SlashGear: slashgear.com
- Reuters, Berichterstattung zum Microsoft-365-Ausfall, 13. und 14. November 2026
- NBC News, Microsoft scrambles to fix major outage affecting millions worldwide: nbcnews.com
- Swiss IT Magazine, Outlook und Teams von weltweiter Störung betroffen: itmagazine.ch